Technische SEO-checklist voor Google en AI-crawlers
TDK Tanguy De Keyzer Oprichter & GEO-strateeg · · Bijgewerkt · 10 min leestijd
Kopieer voor AI
De korte samenvatting
Een technische SEO-checklist controleert of Google en AI-crawlers je pagina's kunnen bereiken, lezen en correct indexeren. Begin bij toegang (robots.txt, firewall, statuscodes), dan indexering, rendering, snelheid en structuur. Voor Google AI Overviews gelden geen extra technische eisen, maar voor ChatGPT telt een aparte crawler. Een llms.txt-bestand of speciaal AI-schema hoort niet op de lijst.
Een technische SEO-checklist controleert of zoekmachines en AI-crawlers je pagina’s kunnen bereiken, renderen en correct indexeren.
De lijst hieronder telt zes blokken: toegang, indexering, rendering, snelheid, structuur en AI-crawlers. Elk punt is getoetst aan de documentatie van Google.
Het is dezelfde basis die we bij technische SEO voor klanten controleren.
Je hoeft niet alles in één keer te doen. Werk van boven naar onder: een fout in toegang maakt alle punten daaronder zinloos.
Wat staat er op een technische SEO-checklist?
Een technische SEO-checklist bestaat uit zes blokken in een vaste volgorde. Kan een bot je site bereiken? Worden je pagina’s geïndexeerd? Ziet de bot dezelfde inhoud als je bezoeker?
Daarna volgen snelheid, een logische structuur en een bewuste keuze over welke AI-crawlers je toelaat.
Waarom deze volgorde?
Die volgorde volgt hoe Google zelf werkt: eerst crawlen, dan indexeren, dan pas rangschikken.
Zo komt een pagina in Google en in AI-antwoorden
- 01CrawlenEen bot haalt de pagina op
- 02IndexerenDe pagina komt in de index
- 03RangschikkenGoogle toont of citeert de pagina
Een pagina die niet gecrawld of geïndexeerd wordt, kan niet ranken en kan ook niet geciteerd worden in een AI-antwoord.
De zes blokken in één tabel
De tabel hieronder vat de zes blokken samen, met de tool waarmee je elk blok controleert.
| Blok | Kernvraag | Waarmee controleer je het |
|---|---|---|
| 1. Toegang | Kan een bot je pagina’s ophalen? | robots.txt, serverlogs, URL-inspectie |
| 2. Indexering | Komen de juiste pagina’s in de index? | Rapport Paginaindexering in Search Console |
| 3. Rendering | Ziet de bot wat je bezoeker ziet? | Gerenderde HTML in URL-inspectie |
| 4. Snelheid en mobiel | Laadt de pagina vlot op een gsm? | Rapport Core Web Vitals, PageSpeed Insights |
| 5. Structuur | Is elke pagina via links bereikbaar? | Een crawler zoals Screaming Frog |
| 6. AI-crawlers | Welke AI-bots laat je toe? | robots.txt, firewallinstellingen |
We zagen op 14 oktober 2026 dat geen enkele Belgische pagina in de Google-top 10 stond voor “technische seo checklist”. Wel toonde Google een AI-overzicht.
Daarom deze lijst, in het Nederlands en met de AI-laag erbij.
Kunnen Google en AI-crawlers je site bereiken?
Een bot bereikt je site alleen als robots.txt, je hosting en je firewall hem doorlaten. Je pagina’s moeten bovendien een statuscode 200 geven.
Wat Google vraagt
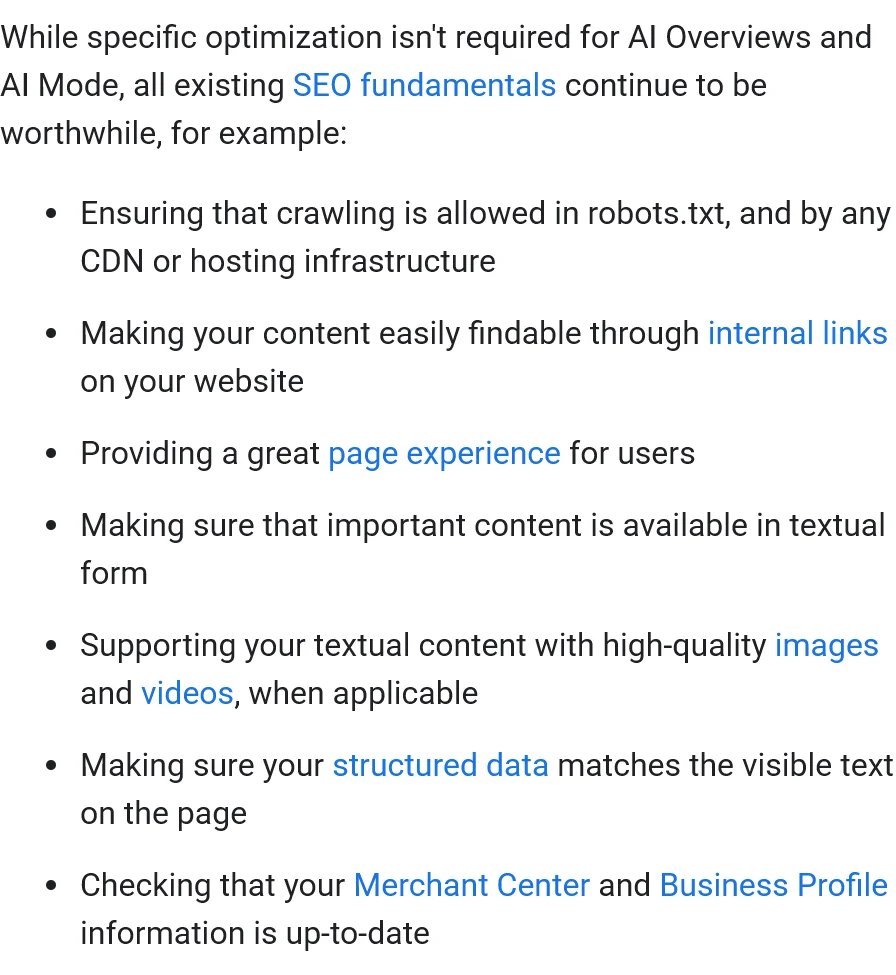
Google vraagt in zijn uitleg over AI-functies in Search uitdrukkelijk om crawlen toe te laten in robots.txt én bij je CDN of hostingpartij.
Kijk naar het eerste punt onder “SEO best practices”: crawlen toelaten in robots.txt en bij elke CDN of hostinginfrastructuur.
Checklist: toegang
Controleer deze punten:
- robots.txt blokkeert geen pagina’s, CSS of JavaScript die Google nodig heeft om te renderen.
- robots.txt verwijst naar je XML-sitemap met een
Sitemap:-regel. - Je botbescherming of firewall (bijvoorbeeld bij Cloudflare) geeft Googlebot geen captcha of blokkade.
- Belangrijke pagina’s geven een 200, verwijderde pagina’s een 404 of 410, verhuisde pagina’s een 301.
- Geen pagina’s achter een login die je wil laten ranken.
Let op: robots.txt regelt crawlen, niet indexeren. Een URL die je in robots.txt blokkeert, kan nog altijd in Google verschijnen, alleen zonder inhoud.
Wil je een pagina uit de index houden, gebruik dan noindex en laat de pagina crawlbaar.
Technische SEO-tips voor Belgische sites
Bij Belgische sites zien we hier vaak dezelfde fout: een beveiligingsplugin of firewallregel die “verdacht verkeer uit het buitenland” weert.
Worden je pagina’s correct geïndexeerd?
Je pagina’s worden correct geïndexeerd als elke pagina één duidelijke URL heeft en naar zichzelf verwijst met een canonical tag. Ze staat ook in je sitemap en draagt geen onbedoelde noindex.
Het rapport Paginaindexering in Google Search Console toont per reden welke pagina’s buiten de index vallen.
Checklist: indexering
Controleer deze punten:
- Elke pagina heeft een canonical naar zichzelf, met een absolute URL.
- http, https, www, zonder www en met of zonder slash leiden naar één versie.
- De XML-sitemap bevat alleen canonieke URL’s die een 200 geven.
-
lastmodin de sitemap verandert alleen bij een echte wijziging. - Geen zachte 404’s: lege of “niet gevonden”-pagina’s die toch een 200 geven.
- Filters, sorteringen en zoekpagina’s maken geen eindeloze reeks URL’s.
Is crawlbudget een probleem?
Crawlbudget is voor de meeste Belgische kmo-sites geen probleem. Google noemt het pas relevant voor sites met meer dan een miljoen pagina’s die wekelijks wijzigen, of meer dan 10.000 pagina’s die dagelijks wijzigen.
Een site van 300 pagina’s verliest dus geen tijd aan crawlbudget. Wel aan dubbele en verweesde pagina’s.
Voorbeeld: de rommel bij Bloovi
Hoe groot die rommel kan zijn, zagen we bij de migratie van Bloovi, een Belgisch nieuwsplatform. Voor de verhuis brachten we drie soorten fouten in kaart:
Technische fouten bij Bloovi voor de migratie
Lees de volledige case van Bloovi.
Wie zulke problemen niet meet voor een verhuis, neemt ze mee naar de nieuwe site.
Ziet een bot dezelfde inhoud als je bezoeker?
Een bot ziet dezelfde inhoud als je bezoeker wanneer de tekst, links, titel en canonical al in de HTML staan of correct renderen.
Google rendert JavaScript met een recente versie van Chrome, maar raadt server-side rendering of pre-rendering aan. Of andere AI-crawlers JavaScript uitvoeren, documenteren de meeste aanbieders niet. Reken er dus niet op.
Checklist: rendering
Volgens de JavaScript-SEO-richtlijnen van Google let je op deze punten:
- De hoofdtekst en interne links staan in de gerenderde HTML. Controleer dat met URL-inspectie in Search Console.
- Links zijn echte
<a href>-links, geen knoppen met een klikfunctie. - Zet geen
noindexin de HTML als je de pagina geïndexeerd wil zien. Google slaat dan mogelijk het renderen over, en JavaScript dat de tag verwijdert, komt niet aan bod. - JavaScript wijzigt de canonical niet.
- Routes werken met gewone URL’s, niet met
#-fragmenten.
Meertalige Belgische sites
Voor meertalige Belgische sites is er een extra punt. Google zegt dat Googlebot meestal vanuit de VS crawlt en geen taalvoorkeur meestuurt.
Een site die bezoekers automatisch naar de Nederlandse of Franse versie stuurt op basis van taal of locatie, toont Google dus misschien maar één versie.
Doe daarom drie dingen:
- geef elke taal een eigen URL
- gebruik hreflang met
nl-BEenfr-BE - laat de bezoeker zelf kiezen
Statische HTML
Een statische site, zoals een site in Astro, levert de volledige tekst meteen in de HTML. Bij een site die de inhoud pas in de browser opbouwt, is dat niet vanzelfsprekend.
Wat niet in de HTML staat, bestaat voor veel AI-crawlers niet.
Hoe snel en mobielvriendelijk moet je site zijn?
Je site is snel genoeg als de meeste pagina’s binnen de drempels van de Core Web Vitals blijven. Google indexeert de mobiele versie van je site, dus die versie telt.
De drie drempels
De drempels zijn:
- Largest Contentful Paint: binnen 2,5 seconden
- Interaction to Next Paint: onder 200 milliseconden
- Cumulative Layout Shift: onder 0,1
Volgens Google worden de Core Web Vitals gebruikt door de rankingsystemen. Google zegt er ook bij dat een perfecte score najagen “alleen voor SEO” misschien niet de nuttigste besteding van je tijd is.
Checklist: snelheid en mobiel
Controleer deze punten:
- Het rapport Core Web Vitals in Search Console toont de meeste URL’s als “Goed”.
- De mobiele versie bevat dezelfde tekst, links en gestructureerde data als de desktopversie.
- Geen pop-ups die de inhoud op een gsm volledig afdekken.
- Afbeeldingen hebben een vaste breedte en hoogte, zodat de pagina niet verspringt.
- De hele site draait op https, zonder gemengde inhoud.
Snelheid is een drempel, geen wedstrijd. Een site die in het groen staat, wint weinig door nog een tiende van een seconde te winnen.
Een site die in het rood staat, verliest bezoekers nog voor Google er iets van vindt.
Welke structuur, links en gestructureerde data horen erbij?
Een goede structuur betekent dat elke belangrijke pagina via gewone links bereikbaar is. Interne links wijzen naar de definitieve URL. Gestructureerde data beschrijft alleen wat zichtbaar op de pagina staat.
Google ontdekt pagina’s vooral via links. Een weespagina zonder interne link wordt dus moeilijk gevonden.
Checklist: structuur en gestructureerde data
Controleer deze punten:
- Geen weespagina’s: elke pagina krijgt minstens één interne link.
- Interne links wijzen naar de canonieke URL, niet naar een redirect.
- Geen redirectketens: een oude URL verwijst in één stap naar de nieuwe.
- Commerciële pagina’s krijgen links vanuit je blog en je vergelijkingspagina’s.
- Organization, BreadcrumbList en Article of LocalBusiness waar het past, gevalideerd met de Rich Results Test.
- Geen markup voor inhoud die niet zichtbaar is.
Voorbeeld: Kaizo
Hoe dat in de praktijk misloopt, zagen we bij Kaizo, een softwarebedrijf voor klantenservice. Een linkaudit in juli 2026 vond 19 weespagina’s en 100 pagina’s zonder één link naar een commerciële pagina.
Bij de latere migratie naar Astro verzamelden we 536 oude URL’s en simuleerden we alle redirects vooraf.
Een fout met afsluitende slashes vingen we zo op in de testomgeving, voor de livegang. Lees de case van Kaizo.
Welke AI-crawlers laat je toe, en wat hoef je niet te doen?
Voor Google AI Overviews en AI Mode heb je geen extra technische maatregel nodig. Je pagina moet geïndexeerd zijn en een fragment mogen tonen.
Voor andere AI-assistenten beslis je per crawler in robots.txt. Bij OpenAI zijn dat er twee: OAI-SearchBot voor de zoekfunctie van ChatGPT en GPTBot voor training.
Checklist: AI-crawlers
De punten voor AI-crawlers:
- Google: robots.txt voor Googlebot is de regeling voor Search, AI-functies inbegrepen. Geen
nosnippetofmax-snippet:0op pagina’s die je geciteerd wil zien. - Google-Extended: dit token regelt training en grounding voor Gemini. Volgens Google heeft het geen invloed op je opname in Google Search en is het geen rankingsignaal.
- OpenAI: sites die OAI-SearchBot blokkeren, verschijnen volgens OpenAI niet in de zoekantwoorden van ChatGPT. GPTBot blokkeren betekent alleen dat je inhoud niet voor training gebruikt wordt.
- Je firewall laat de AI-crawlers door die je in robots.txt toelaat.
- Search Console, instelling voor generatieve AI: staat op Include (de standaard).
Een AI-crawler blokkeren is een zakelijke keuze, geen technisch detail. Wie GPTBot weert om training te vermijden, kan OAI-SearchBot toch toelaten om in ChatGPT Search te verschijnen.
Op onze eigen site laten we alle crawlers toe, omdat geciteerd worden net het doel is.
Wat niet op de lijst hoort
Deze dingen heb je niet nodig:
- een llms.txt-bestand
- AI-tekstbestanden
- speciale schema voor AI
- je teksten in stukjes knippen
Google schrijft dat je geen nieuwe machineleesbare bestanden, AI-tekstbestanden of speciale markup nodig hebt voor zijn AI-functies.
Onderhoudslijst, geen migratieplan
Deze checklist is een onderhoudslijst, geen migratieplan. Verhuis je naar een nieuw platform of domein, dan heb je een volledig redirectplan nodig en een controle van elke oude URL na de livegang.
Daarvoor is SEO-veilige websitemigratie een apart traject.
Welke punten een volledige audit daarnaast nog controleert, van content tot AI-vermeldingen, lees je in onze checklist voor een SEO- en GEO-audit. De fixes zelf, van redirects tot rendering, vallen onder technische SEO en AI-crawlers.
Wil je weten welke punten op jouw site rood staan? Een SEO- en GEO-audit loopt deze lijst door en zet de fouten in volgorde van impact.
Veelgestelde vragen
Hoe vaak moet je een technische SEO-check doen?
Volg Search Console elke maand op: het rapport Paginaindexering en de Core Web Vitals tonen nieuwe problemen meestal snel. Een volledige technische check doe je best na elke grote wijziging, zoals een nieuw thema, een nieuwe taal of een migratie, en anders één keer per jaar.
Kan ik een technische SEO-checklist zelf afwerken?
De eerste punten wel: robots.txt bekijken, de sitemap controleren en de rapporten in Search Console lezen. Rendering, redirects en canonicals vragen meer kennis. Daar kan één verkeerde regel honderden pagina’s uit de index halen. Wat je zelf aankan, lees je in SEO uitbesteden of zelf doen.
Moet ik GPTBot blokkeren in robots.txt?
Dat hangt af van wat je wil. Blokkeer je GPTBot, dan gebruikt OpenAI je inhoud niet voor training, maar je kan nog in ChatGPT Search verschijnen als je OAI-SearchBot toelaat. Wil je zo vaak mogelijk geciteerd worden, laat dan beide toe.
Is technische SEO anders voor een webshop?
De basis is dezelfde, maar een webshop heeft meer risico op dubbele URL’s door filters, sorteringen en varianten. Controleer daar vooral canonicals, parameters en productmarkup. Houd ook je productgegevens in Google Merchant Center actueel.
Geschreven door Tanguy De Keyzer Oprichter & GEO-strateeg Tanguy De Keyzer is oprichter en GEO-strateeg bij SEO GEO Agency in Antwerpen. Hij helpt bedrijven gevonden worden in Google en geciteerd worden in AI-antwoorden. Gratis AI-zichtbaarheidsscan
Word jij genoemd wanneer klanten het aan AI vragen?
We meten je zichtbaarheid in Google, ChatGPT, Perplexity en AI Overviews en tonen je de drie grootste kansen.
Vraag je scan aan